高级搜索参数
https://api.goanyapi.com/api/v1/google-scholar运行后在这里查看可视化
响应会自动整理成指标、列表和表格,和右侧 JSON 一一对应。
运行后在这里查看响应
登录后运行测试,查看本次查询的实际响应;非空成功结果按上方费用扣费。
原站里的这些信息,对应哪些字段?
以 machine learning 的公开搜索结果为例,核对文献卡片与响应字段。 查看 Google Scholar 原站
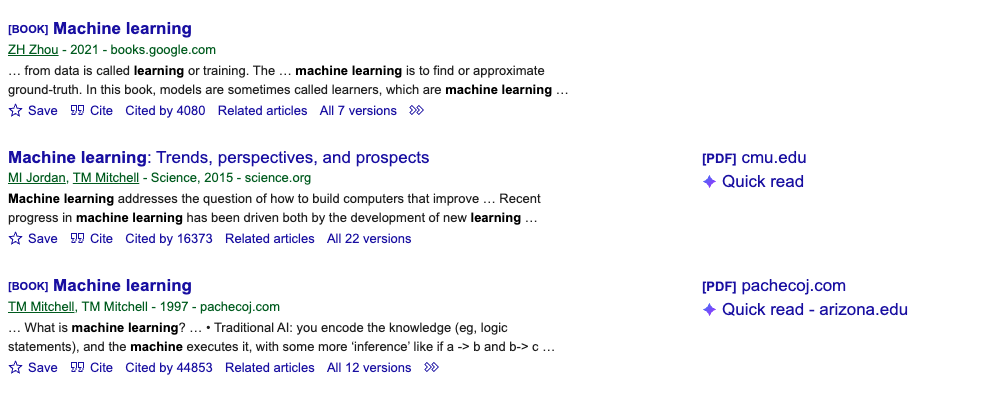
原站可见元素 → JSON 字段
- 蓝色文献标题
data.result.content.results[].title / data.result.content.results[].url文献标题与目标链接;这里也包含书籍。
- 标题下的发表信息
data.result.content.results[].publication_info原站可见的作者、年份与来源信息。
- 标题下的摘要片段
data.result.content.results[].snippet搜索结果片段,通常不是完整摘要。
- Cited by 链接
data.result.content.results[].cited_by / data.result.content.results[].cited_by_url可见引用计数与查询入口;数字 cites 参数取自链接。
- All … versions 链接
data.result.content.results[].versions / data.result.content.results[].versions_url可见版本说明与查询入口;数字 cluster 参数取自链接。
结果排序、引用次数和版本数量会随时间、语言与查询变化。cites / cluster 是从链接解析的参数,不是截图直接显示的 ID;截图中的 Cite、Save、Quick read 不代表本接口支持这些操作。
把文献检索变成可核对的 AI 研究任务
先检索,再由 AI 整理线索并保留来源。以下为可复制的任务示例;当前生产 Catalog 尚未收录本工具,连接后需先检查工具列表,未开放时不要执行。
整理技术文献候选
为出海产品的技术选型先建立阅读清单,例如检索 RAG 评估相关文献。AI 整理的是候选线索,结论仍需回到原文验证。
请使用 GoAnyAPI Google Scholar 工具,检索 retrieval augmented generation evaluation,设置 as_ylo=2024、as_yhi=2026、page=1、num=10。仅请求这一页,不自动翻页。根据实际返回的 title、url、publication_info 和 snippet,整理技术文献候选,按与研究目标的相关性说明理由;保留原始标题、来源链接和查询条件。snippet 只作为搜索摘要片段,不当作完整摘要或已读全文。缺失字段注明未提供,不编造作者或结论。若工具不可用则停止。为 AI 应用与出海技术研究提供文献线索
接口负责取回搜索结果;Agent 负责按你的目标整理。保留链接和筛选条件,才能复核每条建议。
围绕技术问题筛选文献
按主题、发表年份和综述条件缩小候选范围,先读摘要片段,再决定哪些原文值得进一步阅读。
沿引用关系发现后续工作
从返回链接提取 cites 查询引用文章;在有限页数内整理后续研究,注明采样范围。
为知识库准备可追溯来源
将标题、链接与发表信息交给自己的知识库流程。全文获取、文本切分和入库需另外实现。
从搜索结果到可核对的研究清单
下面展示请求写法与字段用途。上方 Tester 保留 machine learning 的真实保存示例;它不是本次查询结果,也不代表当前引用次数。
GET https://api.goanyapi.com/api/v1/google-scholar?query=retrieval+augmented+generation+evaluation&as_ylo=2024&as_yhi=2026&page=1&num=10
Authorization: Bearer YOUR_API_KEY
请求格式示例,不是实测结果。年份范围可按研究主题调整;page 与 start 不可同时传入。
关键字段路径
data.result.content.results[].title- 文献标题,可能包含书籍等类型标记;不要将所有条目都当成期刊论文。
data.result.content.results[].publication_info- 发表信息,可能为文本或结构化值;只提取实际提供的作者、年份等信息。
data.result.content.results[].snippet- 搜索摘要片段,可能截断或缺失,不能替代完整摘要或全文。
data.result.content.results[].cited_by_url- 查询引用文章的入口。从链接读取 cites,不使用 results[].id。
data.result.content.results[].versions_url- 查询文献版本的入口。从链接读取 cluster;调用时不传 query 或 cites。
data.result.content.has_next_page- 响应提供时用于判断是否继续翻页;缺失时不推算完整覆盖或总数。
Google Scholar API 常见问题
按 GoAnyAPI MCP 指南,在支持 MCP 的客户端完成连接与账户授权,并检查工具列表是否包含 goanyapi_google_scholar。当前生产目录尚未收录本工具,不能仅因连接成功就认为可用;开放后可复制上面的任务请求。HTTP 集成方式见接口文档。
接口返回检索结果,Agent 可以据此整理阅读清单和研究问题。只看搜索摘要不能验证论文方法或结论;完整综述还需阅读原文、核对来源,并明确检索范围。不要把一页候选当成完整文献覆盖。
不一样。cites 查询哪些文章引用了选定文献;本接口不提供 APA、BibTeX 等格式导出,也不提供作者主页详情。
snippet 是搜索摘要片段,不保证完整。resource 或 url 可能指向 PDF、出版社页面或其他资源;接口不下载全文,也不保证所有链接开放访问。
language 控制界面语言,不等于只返回英文文献。需要限制结果语言时使用 lr,例如 lang_en;检索词也应按目标研究领域选择。
分别从实际返回的 cited_by_url 读取 cites、从 versions_url 读取 cluster。cites 可搭配 query 缩小范围;cluster 与 query、cites 互斥。没有对应入口时不要猜测 ID。
先限定关键词、年份和最多页数。非空成功页按当前配置计费,重复成功请求和引用、版本查询分别计费;空结果、无效请求与失败不扣费。当前费率见 Tester 与 Docs。
日期排序和年份筛选可用于再次查询,但本接口没有内置定时、存储或通知。持续跟踪需由客户端或外部工作流执行,并自行去重、保存查询条件及结果。
继续研究
按研究任务选择下一种数据,分别请求并核对结果。